01表格和图片,两条处理路径
接着上一篇往下聊。
指南经过 MinerU 处理后,表格和图片会走上两条不同的处理路径。
表格要解决的是:解析结果准不准确。
图片更麻烦。你得先想清楚,究竟要把它转换成什么。
02表格:看着正常,不一定真的正确
MinerU 通常会把指南里的表格转换成 Markdown 或 HTML,大概是下面这样:
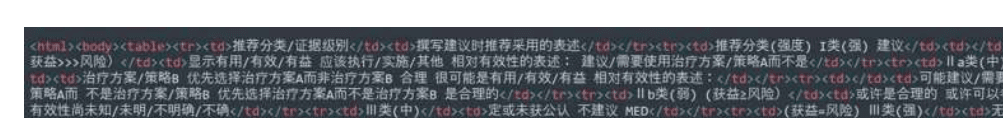
对于结构比较规整的表格,这一步的效果通常不错,原来的行列关系基本都能保留下来。
只要结构没出错,后面的工作就简单了。把表格交给大模型,让它转写成自然语言,目前大部分模型都能稳定完成。
所以刚开始处理时,我觉得表格应该是最省心的一类内容。
在人工检查换行问题时,我顺便核对了一些表格,很快就发现:表格格式正常,不代表信息的对应关系一定正确。
部分指南中的表格没有完整框线,部分单元格之间的边界也不明显。MinerU 遇到这类表格时,偶尔会把原本属于两个单元格的内容合并到一起。
麻烦的是,这种错误往往不显眼。
输出结果仍然是一个合法的 Markdown 或 HTML 表格,行和列看起来也像那么回事,但其中一些内容已经放错了位置。
在医疗指南里,这类错误不能轻视。适用人群、治疗条件、证据等级和推荐意见,任何一项对应错位,都可能改变原文的意思。后面即使让大模型把内容改写得再流畅,也只是在加工一份错误的信息。
因此,人工审核表格时,我不会逐字核对 OCR 结果,而是重点检查三件事:
- 行列关系是否正常;
- 单元格有没有被错误合并;
- 字段之间的对应关系是否和原表一致。
结构正常的表格,可以直接进入后续自动化处理。
如果已经出现明显的结构异常,我会转为人工处理,没有继续设计所谓的“通用修复规则”。
原因也很现实:这类异常占比不高,错误形式却五花八门。为少数情况维护一套越来越复杂的修复逻辑,未必比人工改几张表更省时间,而且可靠性也不好保证。另一方面本来就有需要人工核验的换行问题,这并不会显著增加工作量。
03图片:难点不是识字,而是还原关系
图片比表格难处理得多,尤其是诊疗指南里的流程图。
一张流程图里可能同时包含判断条件、分支路径、前后步骤、并列关系,以及不同治疗方案之间的选择。很多内容必须结合箭头和位置才能看懂。
所以核心问题就是:怎样把一张复杂流程图转换成文本,同时尽量保留原图的信息和逻辑?
04第一次尝试:转换成 Mermaid
我最先尝试的是把流程图转换成 Mermaid。
Mermaid 本身是一种文本格式,可以用代码描述节点、连线和分支,需要时还能重新渲染成图。这些特点刚好和流程图的结构相匹配。
原图里的判断节点、流程走向和层级关系,基本都能保留下来。相比直接改写成自然语言,Mermaid 对结构的还原更直观,也方便直接存进 Markdown 文档。
所以一开始,我觉得它很适合用来处理指南中的流程图,也适合作为知识库的内容格式。
但真正放进知识库测试后,效果没有预想中稳定。只保留 Mermaid,检索命中率会出现比较明显的波动。
具体原因,我准备放到后面讲知识库检索时再展开。
这轮测试至少说明了:能够准确还原原图的格式,未必适合知识库检索。
05Mermaid 保留,再补一份自然语言
发现检索效果不理想后,我没有直接放弃 Mermaid。
它在保留结构方面依然有价值。复杂流程里的分支、回路和前后依赖,如果全部改写成自然语言,有时反而不够直观。
我最后采用的办法,是同时保留两份内容。
第一份是 Mermaid,用来记录流程图里的节点、判断、分支、连线和前后依赖。
第二份是自然语言描述。
这里的自然语言不是简单总结,也不是把图里的文字抄一遍,而是把整张流程图的逻辑完整展开。例如:
- 满足什么条件时进入某个分支;
- 条件成立后应该采取什么措施;
- 条件不成立时转向哪条路径;
- 不同治疗方案各自适用于哪些情况;
- 完成某个步骤后还需要判断什么。
理想状态是,即使读者完全看不到原图,只看这段文字,也能理解流程图的大部分内容。
这样处理后,两种格式各有分工。
Mermaid 负责保存结构,自然语言负责补充语义,也更贴近用户将来可能提出的问题。
06与其寻找“最佳格式”,不如保留两种表达
做到这里,我才意识到,最开始的问题可能问错了。
与其纠结“图片应该转换成哪一种格式”,不如先想清楚后面要怎么使用这些内容。
复杂图片很难靠一种格式兼顾所有需求。
Mermaid 适合保留结构,但对自然语言检索不够友好;自然语言容易被搜索和理解,却可能弱化流程图里的空间关系。
因此,我没有强行统一格式,而是采用了双轨表达:
- 用 Mermaid 保留流程结构;
- 用自然语言承接检索和问答。
这也成了我后来处理指南图片时的一条基本原则:
预处理不是把原始文档原样复制成另一种格式,而是在尽量保留信息的前提下,让内容更容易被检索,也更容易被模型理解。
对于流程图,需要同时检查两个问题:结构是否保留下来了,以及用户以后用自然语言提问时,能不能找到这些内容。
07单张图片处理完了,批量处理又成了新问题
如果只处理几份指南,这套方法并不复杂。
把表格图片分别交给模型,生成对应描述,再人工核对一遍,基本就能完成。
可是一旦指南数量增加,问题马上就变了。
几十份甚至上百份指南里,可能包含大量表格、流程图、示意图和解析异常的内容。如果仍然按照下面的方式操作:
上传图片 → 调用模型 → 复制结果 → 人工检查 → 写回原文档
效率会非常低,而且处理状态也很难管理。
做着做着,很容易弄不清楚:
- 哪些内容已经处理完;
- 哪些内容还没开始;
- 哪些模型输出有问题;
- 哪些地方需要人工介入;
- 修改后的内容是否正确写回;
- 任务中途失败后,应该从哪里继续。
走到这一步,问题已经从“单张表格和图片怎么处理”,变成了“怎样把这些方法组织成一套真正能跑起来的流程”。
这套流程需要支持批量执行、状态监测、人工介入和失败续跑,还要确保处理结果能够准确写回原文档。
下一篇聊聊,我是怎么把表格、图片和文本处理串起来,做成一套批量指南预处理流程的。
DISCUSSION / 讨论
留言与补充
还没有公开评论。